

Statistika · Vodič · · 4 min čitanja
Spajanje kategorija ordinalnih podataka: što gubite dihotomizacijom
Spajanje odgovora s ordinalne ljestvice u dvije skupine briše razlike, smanjuje statističku snagu i može dati lažne nalaze. Objašnjavam što gubite i koje ordinalne metode koristiti umjesto toga.

Ordinalne ljestvice česte su u anketama za diplomske i doktorske radove. Uzmimo primjer: ispitanici procjenjuju svoje zdravlje kao vrlo dobro, dobro, osrednje, loše ili vrlo loše. Kad dođe vrijeme za analizu, primamljivo je odgovore svesti na dvije skupine, povoljno i nepovoljno zdravlje.
To zvuči razumno, ali takvo pojednostavljenje može promijeniti zaključak koji izvodite iz podataka. U ovom vodiču objašnjavam što točno gubite spajanjem kategorija i što možete napraviti umjesto toga.
Što je dihotomizacija i zašto je primamljiva
Dihotomizacija je pretvaranje varijable s više kategorija, ili kontinuirane varijable, u varijablu sa samo dvije vrijednosti. Rezultat je lako opisati jednim postotkom, a analiza se svodi na poznate alate: hi-kvadrat test, omjer izgleda ili binarnu logističku regresiju.
Upravo je ta jednostavnost razlog zašto se dihotomizacija koristi i onda kad za nju nema dobrog razloga. Metodološka literatura, primjerice pregledni rad MacCalluma i suradnika u časopisu Psychological Methods, već dugo upozorava da je cijena tog pojednostavljenja veća nego što se na prvi pogled čini.
Što se gubi kad spojite kategorije
Razlike unutar skupine. Nakon spajanja „vrlo dobro“ i „dobro“ postaju isti odgovor. Ako se zdravlje nekog ispitanika pogorša s vrlo dobrog na dobro, u dihotomnoj varijabli te promjene nema. Ordinalnu ljestvicu možete zamisliti kao kontinuirani doživljaj zdravlja izrezan na pet razreda; spajanjem razreda taj rez postaje još grublji.
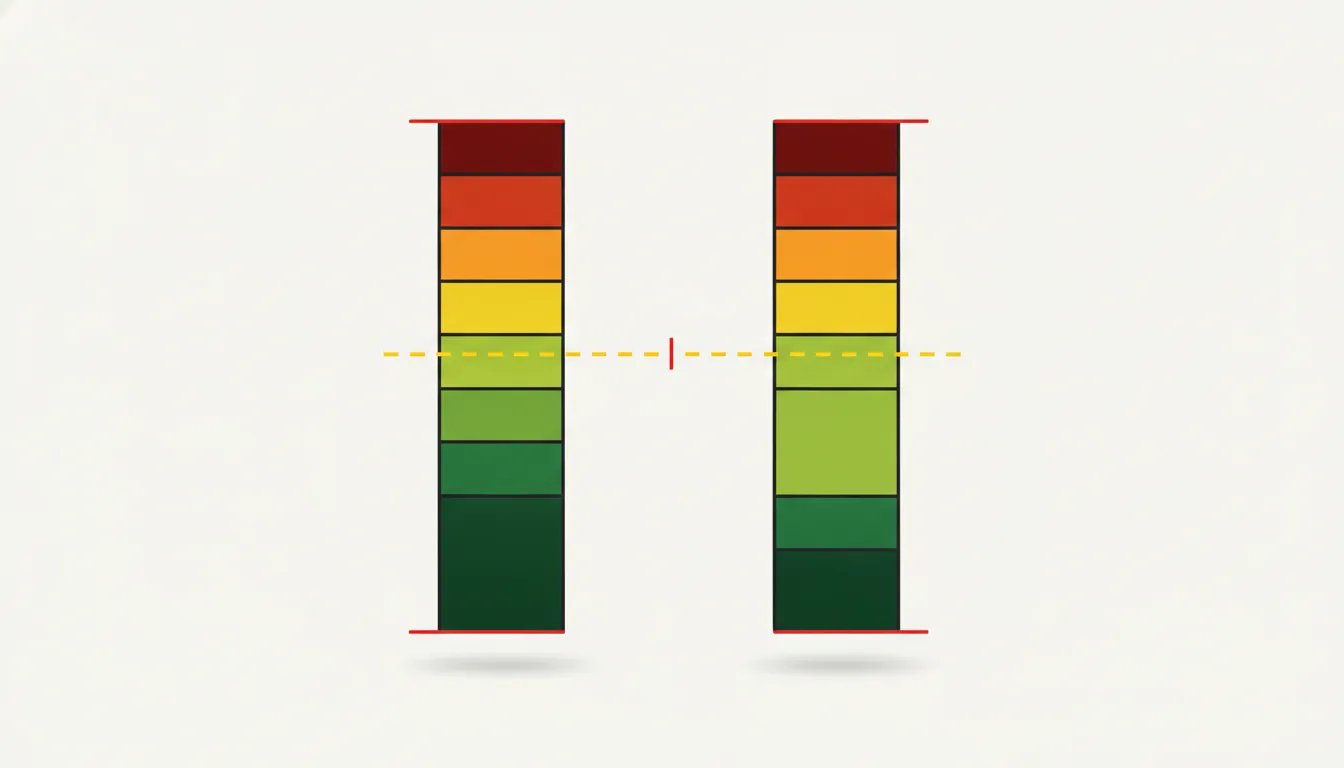 Isti udio povoljnih odgovora, a različita raspodjela unutar skupine. · Ilustracija: generirano AI-jem
Razlike između skupina. Dvije skupine mogu imati jednak udio povoljnih odgovora, a potpuno različitu raspodjelu. U jednoj većina bira „vrlo dobro“, u drugoj „dobro“. Dihotomna analiza reći će vam da su jednake.
Statistička snaga. Manje informacija znači manju preciznost procjena. Spomenuti rad pokazuje da dihotomizacija u pravilu umanjuje opaženu povezanost među varijablama, pa za otkrivanje iste razlike treba veći uzorak i lakše propustite učinak koji stvarno postoji.
Prividni skokovi. Ispitanik koji prijeđe s „osrednje“ na „dobro“ prelazi granicu i izgleda kao velika promjena, dok veći pomak unutar iste skupine ostaje nevidljiv.
Lažni nalazi. Gubitak informacija ne vodi uvijek samo opreznijim zaključcima. Kad se istodobno dihotomizira više prediktora, mogu se pojaviti učinci ili interakcije kojih u izvornim podacima nema.
Gdje povući granicu?
Kod ljestvice s neparnim brojem odgovora problem je srednja kategorija. Pripada li „osrednje“ povoljnom ili nepovoljnom zdravlju? Odgovor može promijeniti rezultat, a ponekad i smjer zaključka.
Dodatna je poteškoća što razmaci između kategorija ne moraju biti jednaki. Udaljenost između „malo vjerojatno“ i „donekle vjerojatno“ može biti manja od one između „donekle“ i „vrlo vjerojatno“, pa „prirodna sredina“ ljestvice često uopće ne postoji.
Posebno je rizično birati granicu nakon što ste pogledali podatke. Tada lako, i nesvjesno, odaberete podjelu koja daje statistički značajan rezultat, što povećava vjerojatnost lažno pozitivnog nalaza. Recenzenti i mentori to pitanje rado postavljaju.
Bolje alternative
- Prikažite cijelu raspodjelu: tablicom frekvencija ili složenim stupčastim grafikonom po skupinama.
- Koristite testove za ordinalne podatke: Mann-Whitneyjev U test za dvije skupine, Kruskal-Wallisov test za više skupina, test trenda za tablice s uređenim kategorijama ili Spearmanovu korelaciju.
- Za modeliranje koristite ordinalnu logističku regresiju (model proporcionalnih izgleda) i provjerite njezinu pretpostavku o proporcionalnosti izgleda.
Obična linearna regresija nije dobra zamjena jer kategorije tretira kao brojeve s jednakim razmacima, a multinomna logistička regresija zanemaruje redoslijed i time baca dio informacija. Ordinalni model kategorije shvaća kao rezove latentne kontinuirane varijable i procjenjuje pragove između njih. Dobiveni proporcionalni omjer izgleda tumači se slično kao u binarnoj logističkoj regresiji, ali vrijedi za svaku podjelu „više naspram niže“. Drugim riječima, model istodobno koristi sve moguće dihotomizacije, umjesto da vi birate jednu. U R-u ga procjenjuje funkcija polr iz paketa MASS, a ordinalni probit daje vrlo slične rezultate i razlikuje se uglavnom u tumačenju koeficijenata.
Pri provjeri pretpostavke budite oprezni: formalni testovi skloni su odbacivati je i kad zapravo vrijedi. Zato je koristan i grafički pristup koji preporučuje Harrell, usporedba predviđenih logita za svaku granicu ishoda. Ako pretpostavka očito ne vrijedi, razmotrite model koji dopušta različite koeficijente za pojedine granice.
Ovi pristupi zadržavaju redoslijed kategorija i ne traže proizvoljnu granicu.
Ako ipak morate spojiti kategorije
Postoje opravdani razlozi: klinički ili praktično važan prag, usporedivost s ranijim istraživanjima ili premalo odgovora u krajnjim kategorijama. Tada:
- Odredite granicu unaprijed, u planu analize.
- Obrazložite izbor u metodologiji.
- Napravite analizu osjetljivosti s drugačijom granicom i provjerite mijenja li se zaključak.
- Uz dihotomni rezultat prikažite i punu raspodjelu odgovora, a po mogućnosti i rezultat ordinalnog modela.
Ukratko
- Spajanje kategorija skriva razlike unutar i između skupina.
- Smanjuje statističku snagu, može stvoriti prividne skokove, pa i lažne učinke.
- Izbor granice utječe na rezultat, osobito kod srednje kategorije i nejednakih razmaka.
- Ordinalne podatke najbolje je analizirati ordinalnim metodama, uz razumnu provjeru proporcionalnosti izgleda.
- Ako dihotomizirate, granicu odredite unaprijed, obrazložite je i provjerite analizom osjetljivosti.
Naslovna: generirano AI-jem
Izvori
- Statistics by Jim — Dichotomizing Ordinal Data: What You Lose by Combining Categories, 2026-11-03
- Psychological Methods (PDF na quantpsy.org, K. J. Preacher) — On the practice of dichotomization of quantitative variables
- UCLA Office of Advanced Research Computing (OARC) — Ordinal Logistic Regression | R Data Analysis Examples


